統計(とうけい)は、たくさんのデータを少しの数でまとめて読むための数学です。AI はデータから学ぶので、データをまとめて読む道具は、AI を作るときにも、AI の仕組みを読むときにも出てきます。
この記事では、平均・分散・標準偏差・確率・正規分布の5つを、小さな数の手計算で確かめます。それぞれの節で、AI のどこで使われているかも添えます。紙とペンと電卓を用意し、途中の小さな問題は答えを読む前に計算してみてください。
AI のどこで統計を使うか
| この記事の言葉 | AI の中での使われ方 |
|---|---|
| 平均 | 学習のときの誤差は、1件ずつの誤差の平均で測ることが多い |
| 分散・標準偏差 | データの数の大きさをそろえる前処理(標準化)に使う |
| 確率 | 画像を見分ける AI は「犬の確率 0.8」のように答える。LLM は次に来る言葉を確率で選ぶ |
| 正規分布 | 学習を始める前に、重み(AI の中の数)の最初の値を決めるのに使う |
どれも、このあとの節で計算してから、もう一度この表に戻ると意味が分かります。
平均
平均(へいきん)は、データを全部足して、データの数で割った数です。5人のテストの点が 60、70、80、90、100 だったとします。
平均 = (60 + 70 + 80 + 90 + 100) ÷ 5 = 400 ÷ 5 = 80
データの1つ1つを x₁、x₂、…、xₙ と書きます。右下の数字は何番目のデータかを表し、n はデータの数です。平均は x̄(エックスバー)か、ギリシャ文字の μ(ミュー)で書きます。
      1   n
x̄ =  ─   Σ  xᵢ
      n  i=1
Σ(シグマ)は「同じ形のものを全部足す」記号で、「i を 1 から n まで変えながら xᵢ を全部足す」という意味です。それを n で割るので、上の計算と同じことを書いています。
平均だけでは分からないこと
別の5人の点が 78、79、80、81、82 だったとします。平均はこちらも 80 です。ただし、1つ目は 60 点から 100 点まで散らばっていて、2つ目は全員が 80 点の近くに集まっています。
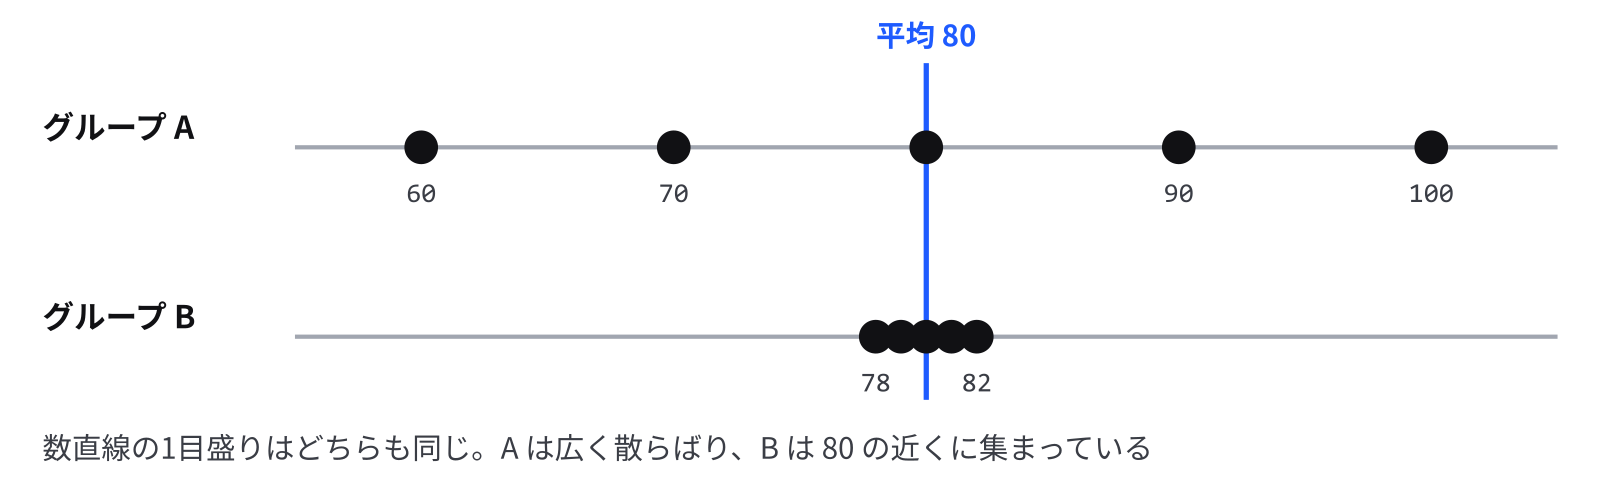
この散らばり方を1つの数で表すのが、次の分散と標準偏差です。
分散と標準偏差
散らばりを測るには、1つ1つのデータが平均からどれだけ離れているかを見ます。データから平均を引いた数を偏差(へんさ)と呼びます。グループ A(平均 80)で計算します。
| データ | 偏差(データ − 平均) | 偏差の2乗 |
|---|---|---|
| 60 | −20 | 400 |
| 70 | −10 | 100 |
| 80 | 0 | 0 |
| 90 | 10 | 100 |
| 100 | 20 | 400 |
| 合計 | 0 | 1000 |
偏差をそのまま足すと 0 になります。平均より上の分と下の分が打ち消し合うためで、どんなデータでも同じです。そこで、偏差を2乗してマイナスを消してから足し、データの数で割ります。この数が分散(ぶんさん)です。
分散 = 1000 ÷ 5 = 200
分散は2乗した数の平均なので、単位も2乗になっています。点数なら「点の2乗」で、元のデータと比べにくいです。分散の平方根(2乗するとその数になる数。√ と書く)を取って、元の単位に戻します。これが標準偏差(ひょうじゅんへんさ)です。
標準偏差 = √200 ≈ 14.1
≈ は「だいたい等しい」という記号です。グループ A の点は、平均の 80 から 14 点ほど離れて散らばっていると読めます。分散は σ²、標準偏差は σ(シグマの小文字)で書くことが多いです。足し算の記号 Σ とは別の意味です。
練習として、グループ B(78、79、80、81、82)の分散と標準偏差を計算してください。偏差は −2、−1、0、1、2、2乗は 4、1、0、1、4 で合計 10 なので、分散は 2、標準偏差は √2 ≈ 1.41 です。グループ A の 14.1 のちょうど10分の1で、点が平均の近くに集まっていることが数で表せました。
n で割るか、n − 1 で割るか
分散を計算するとき、データの数 n の代わりに n − 1 で割るやり方もあります。手元のデータが、もっと大きな集まりの一部(全国の大学生の中から選んだ5人など)で、そこから全体の分散を推し量りたいときに使います。
プログラムで計算すると、この違いが出ます。Python の NumPy(数の計算をする道具)の np.var は n で割り、pandas(表のデータを扱う道具)の .var() は n − 1 で割ります。グループ A では、NumPy が 200、pandas が 1000 ÷ 4 = 250 を返します。同じデータで違う答えが出て迷ったら、どちらで割っているかを確かめてください。
標準化
ばらつきの大きさが分かると、違うデータどうしを比べられます。グループ A の 90 点と、グループ B の 82 点を考えます。点数だけ見ると 90 点のほうが上ですが、グループ B は全員が近くに集まっているので、82 点はグループの中で一番上です。
偏差を標準偏差で割ると、このことが数になります。
z = (データ − 平均) ÷ 標準偏差

グループ A の 90 点:  (90 − 80) ÷ 14.1 ≈ 0.71
グループ B の 82 点:  (82 − 80) ÷ 1.41 ≈ 1.41
z は「平均から標準偏差いくつ分離れているか」を表します。平均を引いて標準偏差で割ることを標準化(ひょうじゅんか)と呼びます。標準化した値は、どんなデータでも平均が 0、標準偏差が 1 になります。学校の偏差値は、この z を10倍して50を足した数で、グループ A の 90 点なら 0.71 × 10 + 50 ≈ 57 です。
AI の中での標準化
AI に家の値段を予想させるとき、材料に「広さ(20 から 200 平方メートル)」と「駅からの距離(0.1 から 3 キロメートル)」を使うとします。そのまま入れると広さの数のほうが大きいので、広さの影響ばかりが強く出て、学習が進みにくくなることがあります。そこで学習の前に、それぞれの項目を標準化して平均 0・標準偏差 1 にそろえます。Python の機械学習ライブラリ scikit-learn には、このための StandardScaler という部品があります。
確率
確率(かくりつ)は、あることの起こりやすさを 0 から 1 までの数で表したものです。0 は起こらない、1 は起こる、0.5 は半々です。50% のように百分率で書くこともあります。
サイコロを1回振って偶数が出る確率を考えます。出る目は 1 から 6 の6通りで、どれも同じ程度に出やすいとします。偶数は 2、4、6 の3通りです。
偶数が出る確率 = 3 ÷ 6 = 0.5
起こりうることを全部挙げて確率を足すと、1 になります。サイコロなら、1 から 6 の目それぞれの確率 1/6 を6つ足して 1 です。確率は P(英語の probability の頭文字)で書き、P(偶数) = 0.5 と書けば「偶数が出る確率は 0.5」という意味です。
AI は答えを確率で出す
画像を見分ける AI に写真を見せると、多くの場合、それぞれの答えの確率を返します。
犬     0.80
猫     0.15
うさぎ 0.05
足すと 1 です。AI はこの中で確率の最も高い「犬」を答えとして表示します。
LLM(ChatGPT などの中で動く、文章を作る AI)も同じです。「今日はいい」の次に来る言葉について、たとえば「天気 0.60、日 0.25、感じ 0.10、そのほか 0.05」のような確率を出し、その確率に従って1つを選びます。毎回、最も高いものを選ぶとは限らないので、同じ質問でも答えが少しずつ変わります。
期待値
確率と平均をつなぐ考え方が期待値(きたいち)です。それぞれの値に、その値が出る確率を掛けて、全部足した数です。サイコロの目の期待値は次のとおりです。
1×(1/6) + 2×(1/6) + 3×(1/6) + 4×(1/6) + 5×(1/6) + 6×(1/6) = 21 ÷ 6 = 3.5
サイコロを何千回も振って出た目の平均を取ると、3.5 に近づきます。期待値は、たくさんくり返したときの平均です。AI の学習の式で E[ ] という記号を見かけたら、期待値(expectation)のことです。
練習として、サイコロで 4 以上が出る確率と、AI が「晴れ 0.5、くもり 0.3、雨 ?」と答えたとき(3つ以外の答えはない)の雨の確率を出してください。答えは 3 ÷ 6 = 0.5 と、1 − 0.5 − 0.3 = 0.2 です。
分布と正規分布
たくさんのデータを集めて、どの値がどのくらい出たかを棒グラフにしたものをヒストグラムと呼びます。その形を、データの分布(ぶんぷ)と呼びます。
ある大学の学生をたくさん集めて身長を測ってヒストグラムにすると、真ん中あたりの身長の人が最も多く、離れるほど少なくなる、左右対称のつりがねの形になります。テストの点や、作った部品の重さの細かいずれなども、この形に近くなります。この形の分布を正規分布(せいきぶんぷ)と呼びます。
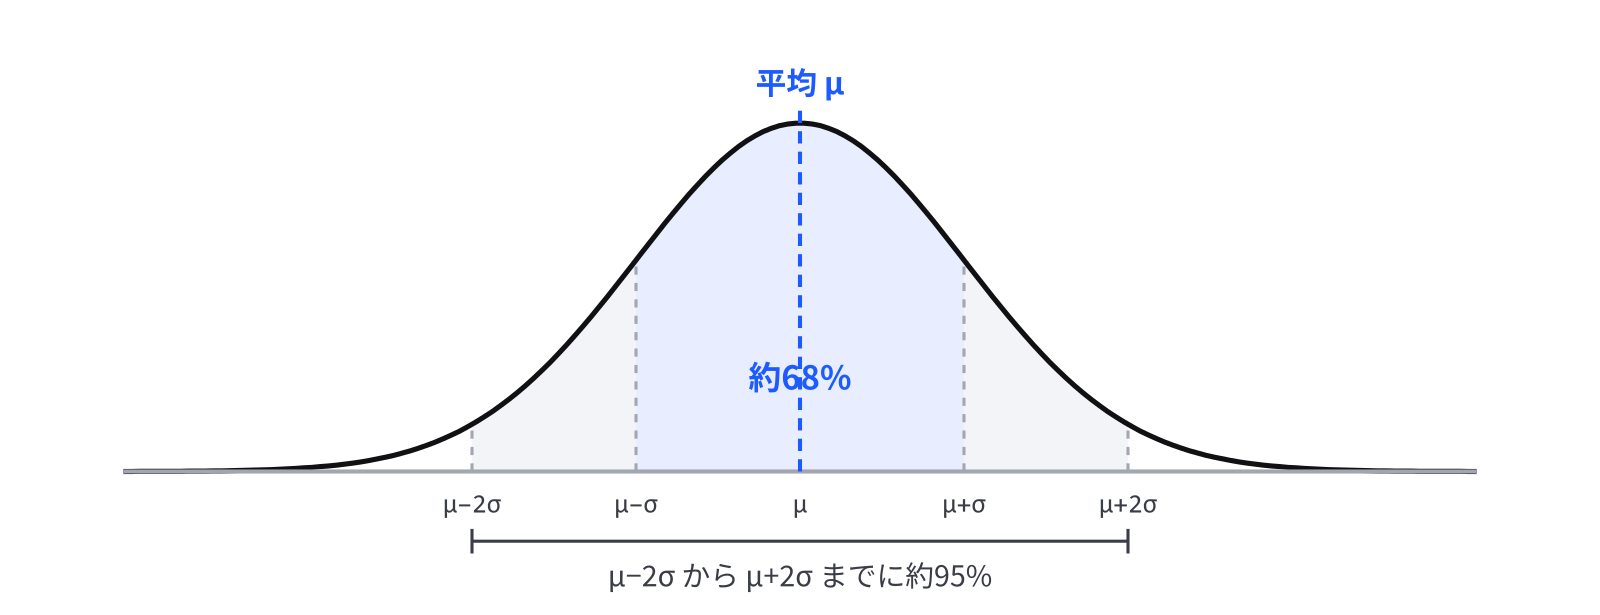
正規分布の形は、平均と標準偏差の2つで決まります。平均が山の真ん中の位置、標準偏差が山の幅を決めます。標準偏差が小さいと細く高い山になり、大きいと低く広い山になります。
標準偏差いくつ分に、どれだけ入るか
| 範囲 | その範囲に入るデータの割合 |
|---|---|
| 平均 ± 標準偏差1つ分 | 約68% |
| 平均 ± 標準偏差2つ分 | 約95% |
| 平均 ± 標準偏差3つ分 | 約99.7% |
身長が平均 171 cm、標準偏差 6 cm の正規分布に従うとすると、165 cm から 177 cm のあいだに約68%の人が、159 cm から 183 cm のあいだに約95%の人が入ります。この割合は、山の形の曲線の下の面積から出しています。曲線の下の面積の全体を 1(100%)として、その範囲の部分の面積が、その範囲に入る確率になります。曲線の下の面積を求める計算を積分と呼びます。
AI の中での正規分布
AI を学習させる前には、重みに最初の値を入れておく必要があります。全部 0 にすると、どの重みも同じように直されて学習が進みません。そこで、平均 0、標準偏差が小さい正規分布に従うばらばらの数を入れて始めることがよくあります。深層学習の道具 PyTorch には、正規分布で数を作る torch.randn などの部品があります。画像生成 AI の中にも、正規分布に従うでたらめな点の集まりから始めて、少しずつ画像に近づける仕組みのものがあります。
式に出てくる記号の読み方
| 記号 | 読み方 | 意味 |
|---|---|---|
| x̄ | エックスバー | 平均 |
| μ | ミュー | 平均(全体の平均や分布の平均に使う) |
| σ | シグマ(小文字) | 標準偏差 |
| σ² | シグマの2乗 | 分散 |
| Σ | シグマ(大文字) | 同じ形のものを全部足す |
| √ | ルート | 平方根 |
| P(A) | ピー・エー | A が起こる確率 |
| E[X] | イー・エックス | X の期待値 |
| N(μ, σ²) | エヌ・ミュー・シグマ2乗 | 平均 μ、分散 σ² の正規分布 |
N(0, 1) は平均 0、分散 1 の正規分布です。標準化したデータが正規分布に従うなら N(0, 1) になります。
課題
8個のデータがあります。紙に答えを書いてから、下の答えと見比べてください。
2, 4, 4, 4, 5, 5, 7, 9
- 平均を計算してください
- 分散を計算してください(データの数 8 で割ります)
- 標準偏差を計算してください
- 9 を標準化した値 z を計算してください
- 8個の中から1つをでたらめに選ぶとき、4 を選ぶ確率はいくつですか
- 平均 ± 標準偏差1つ分の範囲に、8個のうち何個が入りますか。正規分布の約68%と比べてください
答え
- 5 です。合計 40 を 8 で割ります
- 4 です。偏差は −3、−1、−1、−1、0、0、2、4 で、2乗は 9、1、1、1、0、0、4、16、合計 32 を 8 で割ります
- 2 です。√4 = 2
- 2 です。(9 − 5) ÷ 2 = 2。9 は平均から標準偏差2つ分だけ上にあります
- 0.375 です。4 は3個あるので 3 ÷ 8 です
- 範囲は 3 から 7 までで、4、4、4、5、5、7 の6個が入ります。6 ÷ 8 = 75% で、約68%に近い数です。データが8個なのでぴったりにはなりません
この記事で出てきた言葉
| 言葉 | 意味 |
|---|---|
| 統計 | たくさんのデータを、少しの数でまとめて読むための数学 |
| 平均 | データを全部足して、データの数で割った数 |
| 偏差 | データから平均を引いた数 |
| 分散 | 偏差の2乗の平均。散らばりの大きさを表す |
| 標準偏差 | 分散の平方根。元のデータと同じ単位で散らばりを表す |
| 標準化 | 平均を引いて標準偏差で割り、平均 0・標準偏差 1 にそろえること |
| 確率 | あることの起こりやすさを 0 から 1 の数で表したもの |
| 期待値 | 値に確率を掛けて全部足した数。たくさんくり返したときの平均 |
| 正規分布 | 平均を真ん中にした、左右対称のつりがねの形の分布 |
参考にした資料
- 統計WEB「統計学の時間」(Step1 の平均・分散・標準偏差・正規分布・標準化の各ページ。別の例で読み直せます): https://bellcurve.jp/statistics/course/